欧洲云计算机房着火案例分析教科书式的教训与改进措施
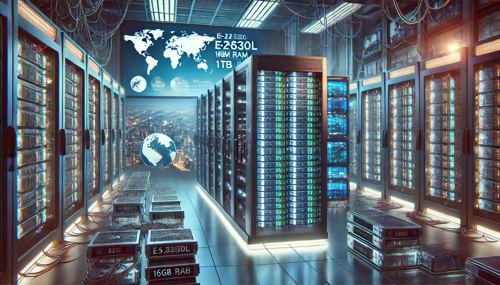
概述与首要结论(最好/最佳/最便宜)
本文基于欧洲近年数起典型的云计算机房着火案例,从服务器
案例回顾与常见根因
在多起欧洲事件中,导致数据中心着火的主要因素包括UPS电池组热失控、PDU或配电柜短路、人为施工引发火花、以及机房空调/冷通道故障引起过热。火势往往由小范围电气故障扩大,快速影响到多台服务器与网络设备,进而导致服务不可用与数据损坏。
教科书式的教训一:冗余与分区
第一条教训是“不要把所有鸡蛋放在一个笼子里”。物理上实现机房级别的多活或多区域部署(至少N+1或2N),并在同一机房内部采用机架级与房间级的电气与网路分区,能在局部火灾时把影响限制在最小范围,保障核心服务器服务不中断。
教科书式的教训二:电池与电气风险管理
UPS电池(尤其是铅酸与锂离子)是触发火灾的高风险点。教训包括:电池间距与隔离、防爆/耐火柜、电池热管理、定期更换与热失控监测。配电柜必须采用规范化接地与短路保护,消除临时电缆绕组与过载使用。
教科书式的教训三:早期检测与抑制系统
传统水喷淋对电子设备破坏严重。最佳实践是部署多层检测(光学烟雾、离子烟雾、温度、红外/热成像)并结合无水灭火系统(惰性气体或化学气体如FM-200),同时在电池室与发电机间采用独立抑制方案。
改进措施:分步实施路线(快速/中期/长期)
快速(0-3月):加强电气巡检、安装早期烟雾与温度传感器、制定紧急断电与疏散流程。中期(3-12月):重构电力回路为冗余供电、隔离UPS电池室、部署机架级温控与防火封闭。长期(1年以上):实现跨地区多活、引入气体灭火与自动化故障切换、持续演练与合规审计。
运维与组织层面的教训
技术以外,事故常暴露沟通、决策与演练不足。建议建立明确的事件响应SOP、定期进行桌面与实战演练、维护第三方应急联系单,并在运维SLA中加入火灾响应与恢复时间目标(RTO/RPO)条款。
成本权衡与ROI分析
不同措施的成本效益差异明显。全面改造(如跨区多活、惰性气体系统)投资大但能最大限度降低停机成本;而早期检测与电气巡检投入小、回报快。建议按重要性分配预算:核心生产服务器与数据库优先级最高,备份与非关键系统可采用成本更低的保护策略。
结论与行动清单(可执行项)
总结:通过物理分区、冗余电力、先进的早期检测与无水灭火、严格的电池管理以及完善的运维流程,可以将云计算机房着火的概率和影响降至最低。建议立即执行的五项动作:1) 安装早期烟温感知与告警;2) 完成UPS电池风险评估并隔离高风险电池;3) 建立机房分区与电力冗余;4) 制定并演练灾备与恢复流程;5) 执行独立第三方消防与电气审计。
-
Top European Server Brands
Top European Server Brands 欧洲是世界上一些最知名和最可靠的服务器品牌的诞生地。这些品牌在服务器市场上享有盛誉,提供高性能、可靠性和安全性。本文将介绍欧洲顶级服务器品牌,以帮助您选择适合您业务需求的最佳选项。 英特尔是全球领先的半导体芯片制造商之一,总部位于美国,但在欧洲有广泛的市场份额。英特尔的服务器2025年4月4日 -
和平精英国服服务器维修
和平精英国服服务器维修 和平精英是一款热门的多人在线游戏,拥有许多玩家。然而,最近国服服务器出现了一些问题,导致游戏的正常运行受到了一定程度的影响。 为了解决这些问题,和平精英官方决定对国服服务器进行维修。维修计划如下: 维修时间:从XX月XX日开始,预计维修时间为XX小时。 维修内容:对服务器硬件进行检查和升级,优2025年3月24日 -
德国熊孩子热衷玩MC服务器
德国熊孩子热衷玩MC服务器 近年来,Minecraft游戏在全球范围内迅速风靡,其中德国的熊孩子们尤其热衷于玩MC服务器。MC即Minecraft的简称,是一款沙盒游戏,玩家可以在其中创造和破坏各种方块,建造自己的世界。本文将探讨德国熊孩子们为何如此热衷于玩MC服务器。2025年5月4日 -
欧洲最大的法国服务器:一站式解决您的服务器需求
欧洲最大的法国服务器:一站式解决您的服务器需求 随着互联网的快速发展,服务器扮演着越来越重要的角色。作为企业或个人用户,拥有一台稳定可靠的服务器是至关重要的。而在欧洲,法国的服务器市场一直备受关注,因为法国拥有欧洲最大的服务器市场之一。在这里,您可以找到各种类型的服务器,以满足不同用户的需求。 法国作为欧洲的经济大国,拥有发2025年6月14日 -

合作案例精选 欧洲服务器推荐品牌 客户成功故事与部署成果
1. 为什么越来越多企业选择在欧洲部署服务器? 欧洲服务器因其地理位置、法规合规与网络互联优势,成为跨境业务首选。对于需要覆盖欧盟市场的企业,选择知名的推荐品牌能确保机房资质、网络骨干与多线接入。很多案例显示,合规性(如GDPR)、低延迟与稳定性是客户决策的核心,良好供应商的售后与本地支持直接影响最终的客户成功故事与长期运营的部署成果。 2.2026年6月1日 -

欧洲标准机房认证流程图与常见审核问题应对建议
核心摘要 本文概述一套符合欧洲标准的机房认证流程图与常见审核问题的应对建议,覆盖服务器与VPS部署、机房环境与电力、域名与CDN配置、DDoS防御与关键网络技术检验点,帮助运维与合规团队在准备材料、现场检查和整改中高效通过认证。 认证流程图步骤 典型流程分为:1)初步评估:核对现有机房与设备清单(含服务器/主机/VPS实例、网络2026年7月24日 -
微软服务器聘请法国海军合作提升网络安全
微软服务器聘请法国海军合作提升网络安全 近日,微软公司宣布将与法国海军展开合作,共同提升网络安全水平。这一举措引起了业界的广泛关注,也为网络安全领域注入了新的活力。 微软作为全球知名的科技公司,一直致力于打造更加安全的网络环境。而法国海军作为法国军队的一部分,拥有丰富的网络安全经验和技术。双方的合作将在技术研发、信息共享、联合2025年7月9日 -
苹果服务器英国位置查询
苹果服务器英国位置查询 苹果公司是全球知名的科技公司,其产品和服务广受欢迎。苹果的服务器分布在全球各地,以提供稳定和高效的服务。本文将重点介绍苹果服务器在英国的位置。 苹果公司在英国设有多个服务器位置,以满足用户的需求。其中一些位置包括: 伦敦 伦敦是英国的首都和最大城市,也是苹果在英国设立服务器的主要位置之一。伦敦作为国际金2025年3月30日 -
美国没收德国服务器:重大数据安全事件揭示
美国没收德国服务器:重大数据安全事件揭示 最近,一起引起全球关注的事件发生了:美国政府没收了位于德国的一批服务器。这一事件不仅引发了德国政府和企业的强烈抗议,也引发了对数据安全和隐私权的广泛讨论。 根据报道,美国政府以涉嫌恐怖主义活动为由,要求德国公司将其服务器交给美国执法机构2025年3月26日